
어제부터 AMD의 배수진 할로겐서버 올려서 열심히 사용중입니다.
클로드코드에 물려서 토큰을 아끼는 용도로 쓰고있는데 아주 좋네요.
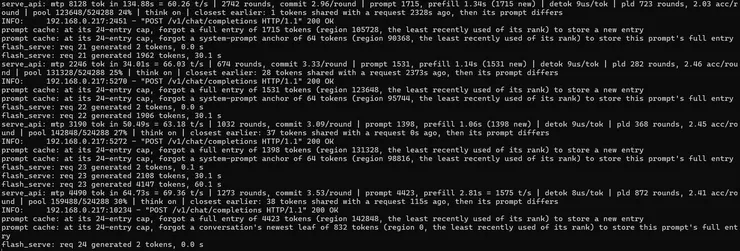
리눅스에서 halogen git의 내용에 따라서 설치했을때 prefill 1000 token/s, 요청당 43~46 token/s 였는데
gpt에 "야 이거 NPU까지 땡긴다고 하지 않았냐? 그거 되게 해줘" 했더니 업데이트 방법을 알려주더라구요
그 방법대로 갖다붙여서 작업해놨더니 성능이 대폭 올라버렷습니다.
prefill 1450~1550 token/s , 요청당 63~73 token/s 나오네요.
뭔가 기분이가 좋습니다. StrixHalo 기본값이 45-50 token/s 인데 진짜 AMD용으로 깎아서 만들었단 느낌입니다.
2대에서 GLM 5.3 Flash 돌리는데 아주 똑똑하게 일 잘하고 60tok/s 수준을 잘 뽑아주네요.