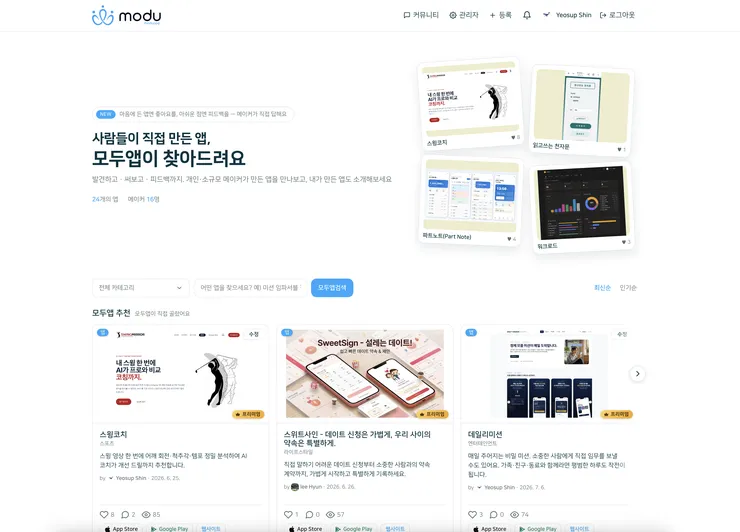
인디 앱·웹서비스 모아놓고 찾아주는 사이트를 만들어 운영 중입니다.
개인이나 소규모로 만든 앱은 알려지지 않아 이름을 모르니까 스토어에서 검색으로 못찾습니다.
그래서 검색을 키워드가 아니라 의미로 붙였습니다. bge-m3 임베딩 + pgvector 인데, "스포츠 관련 앱"이라고 치면 "스윙코치" 앱(현재는 스윙 코기 하나가 스포츠 관련 앱 입니다.)이 나옵니다.
[검색 쪽 구성]
앱을 등록하면 이름 + 한줄소개 + 본문 + 카테고리 + 태그를 bge-m3로 1024차원 임베딩해서 pgvector에 넣고, 검색어도 같은 방식으로 임베딩해 코사인으로 비교합니다.
앱이 24개뿐이라 벡터 인덱스는 안 걸었습니다(순차 스캔이 현재 더 빠름). 검색 전체는 1.2~1.8초인데 대부분 LLM 게이트 몫이라 여기 줄이는 게 다음 숙제입니다.
스택은 NestJS + Prisma + PostgreSQL(pgvector) + React 입니다.
등록도 이용도 무료입니다. 나중에 상단 노출 유료화는 검토하고 있습니다.
만드신 앱 있으면 올려두셔도 되고 구경만 하셔도 됩니다. 검색이 엉뚱하게 나오는 케이스 제보해주시면 제일 감사하겠습니다.
토큰 관련은 SQL이 이미 잘라낸 후보(현재는 최대 12개)만 넘기고 필드도 이름, 카테고리, 한줄 소개만 보내고 있습니다. 본문은 제외 입니다. 아직까지는 실특에서 후보 개수 평균이 1.7이라 더 줄일 여지가 없습니다. 그러나 현재 로컬 llm 사용으로 인해 지연시간과 gpu 점유 때문이지 토큰 부담에 대한 이슈로 인함은 아닙니다.
참고로 gpu는 RTX 4060 Ti 16GB 한 장이고 같은 서버에서 도는 다른 프로젝트 배치가 있어 부하 분산이 필요했고 임베딩은 cpu로 내렸습니다. 다시 한 번 좋은 말씀 감사합니다!!
서빙을 Ollama로 하고 계시면 공식 FAQ에 기본값이 마지막 사용 후 5분 뒤 언로드라고 적혀 있습니다. keep_alive에 음수를 주면 계속 올려두고 0이면 요청마다 내립니다. 같은 서버에서 다른 배치가 GPU를 잡는 구성이면 검색이 뜸한 사이 모델이 내려갔다 다시 올라오는 시간이 지연에 그대로 얹히니까, 1.2~1.8초 중에 첫 요청만 유독 느린 구간이 있는지 보시면 구분이 될 것 같습니다.
임베딩 쪽은 bge-m3 모델 카드에 쿼리에 지시문을 따로 붙일 필요가 없다고 적혀 있고 지원 길이도 8192 토큰이라, 이름과 카테고리와 한줄 소개만 넣으시는 지금 구성이면 CPU로도 여유가 있어 보입니다.
배치가 도는 시간대와 검색이 몰리는 시간대는 겹치나요? 겹치지 않으면 배치 쪽 실행 시각만 못 박아도 꽤 빠질 것 같습니다.
음수를 사용하지 않는 건 인스턴스 설정을 잘못 건드렸을 때 자동 회수될 여지를 남겨두기 위함 입니다. 그리고 부하 분산은 ollama 인스턴스를 셋으로 쪼개는 구조로 풀었스니다. 임베딩은 이전에 말씀드린 부분과 같이 cpu로 내려 vram을 전혀 안쓰고 게이트는 작은 qwen2.5로 낮춰 다른 프로젝트가 쓰는 10.3기가와 합쳐도 16기가 안으로 들어 옵니다. 인스턴스가 분리되어 있어 서로 모델을 밀어내는 일이 없습니다. 여러모로 좋은 말씀 감사합니다!!
제가 만든 앱은 못찾아주네요
*_*;